Inferenza e modelli eseguiti on-premise su GPU locale: assistenti, estrazione documentale e automazioni, senza inviare un solo dato fuori dal tuo perimetro.
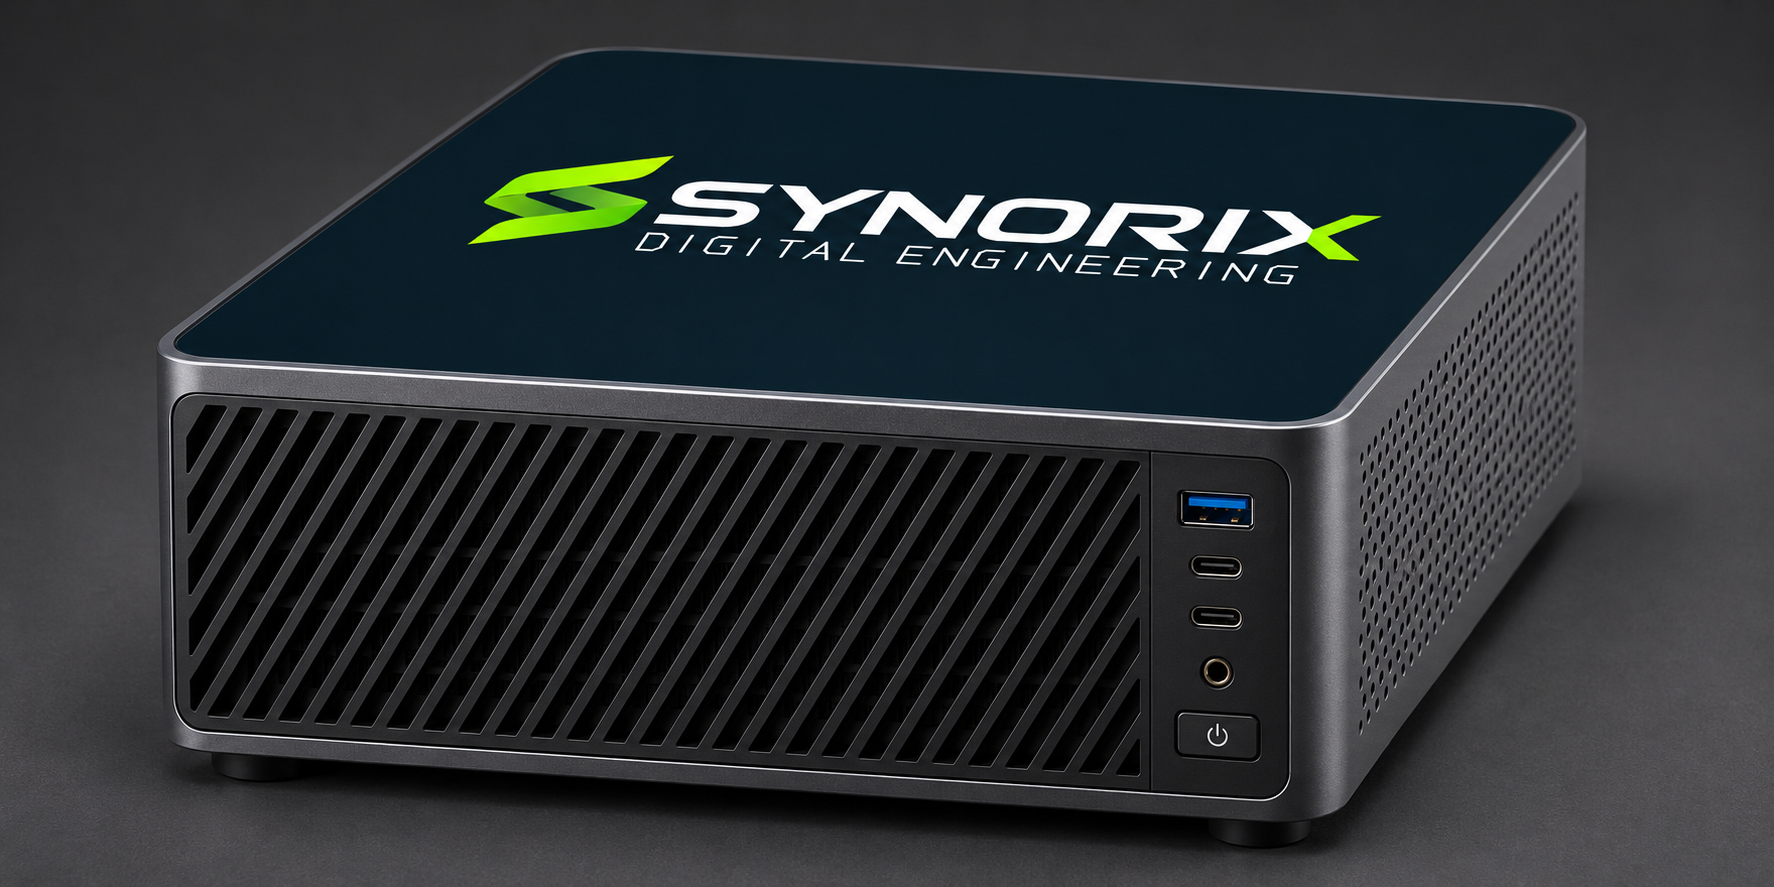
LLM e modelli di visione eseguiti sulla tua appliance, con gateway compatibile OpenAI.
Nessun dato lascia l'azienda: conforme per impostazione a privacy e EU AI Act.
API, strumenti e connettori per collegare l'AI ai tuoi gestionali e portali.
Estrazione, classificazione e risposta su documenti e knowledge base interne.
Fine-tuning e prompt-engineering sui tuoi casi d'uso, con valutazione della qualità.
Dimensionamento GPU per latenza e numero di utenti; scalabile per nodi.
| Esecuzione | On-premise · GPU locale |
| Compatibilità | Gateway stile OpenAI (LiteLLM) |
| Modelli | LLM, visione, embedding · open e custom |
| Conformità | EU AI Act · dati nel perimetro |
| Casi d'uso | Assistenti · estrazione documentale · automazioni |
| Fornitura | Appliance · software · gestita |
| SYNORIX | Fai-da-te / multi-fornitore | |
|---|---|---|
| Dati fuori dall'azienda | — | Spesso sì (cloud) |
| Costo prevedibile | ● | A consumo variabile |
| Modelli personalizzati | ● | Limitato |
| Funziona offline | ● | — |
| Allineato EU AI Act | ● | Da verificare |
Una demo, una scansione gratuita della tua superficie d'attacco o un preventivo hardware: scegli da dove partire.